Duże modele językowe zwykle traktuje się jak czarną skrzynkę: prompt wchodzi, tekst wychodzi, a to, co dzieje się pomiędzy, zostaje w środku. LLM-Scope otwiera tę skrzynkę na prawdziwym modelu, ale na tyle małym, że da się go uruchomić na każdym komputerze — Qwen3-0.6B, 28 warstw.
Aplikacja pokazuje każdą liczbę, która powstaje po drodze: aktywacje neuronów, wagi attention, pośrednie predykcje na każdej głębokości i pełną drogę pojedynczego tokenu przez sieć.
Statyczna wersja demo: mpiotro4.github.io/LLM-Scope
kod źródłowy: github.com/mpiotro4/LLM-Scope.
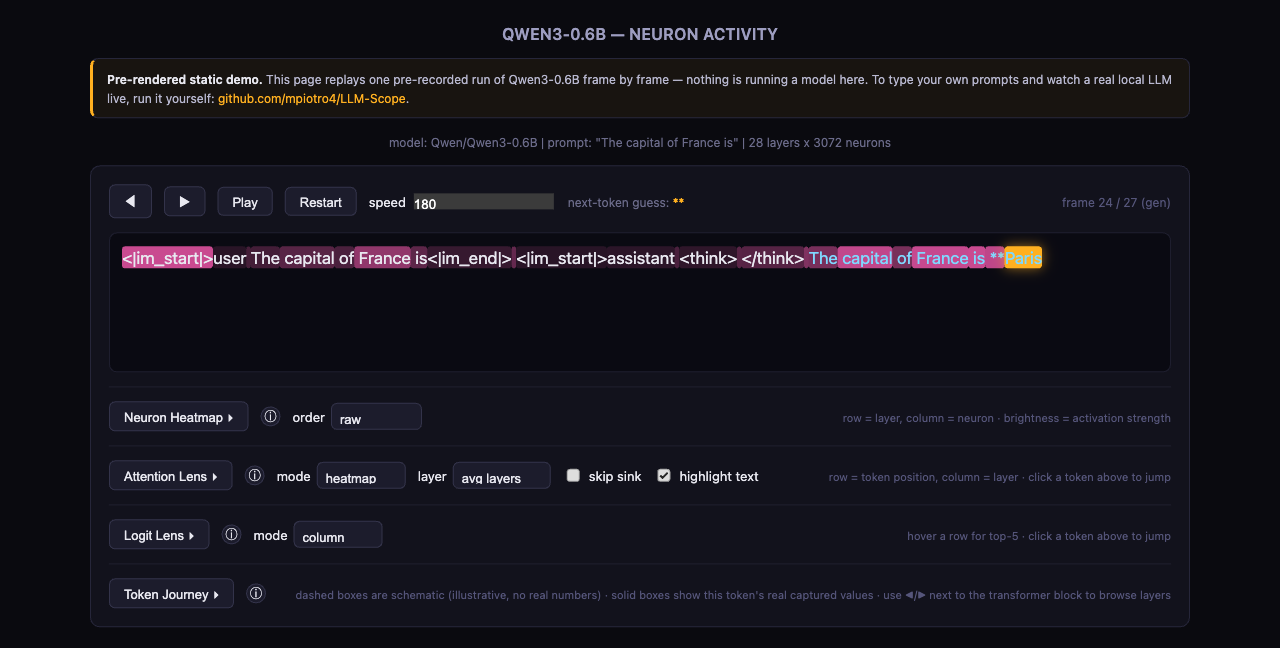
Każdy panel jest osobno zwijalny i ma własny przycisk ⓘ z dłuższym wyjaśnieniem — całą resztę tego wpisu można też po prostu przeklikać samodzielnie w demie.
Jak korzystać
Wpisz prompt, model generuje odpowiedź, a aplikacja odtwarza całość jako klatki: jedna klatka to jeden token. Klatki można przewijać strzałkami, puścić jak animację i regulować tempo — najpierw widać fazę czytania promptu, potem generowanie kolejnych tokenów.
Kluczowe jest to, że wszystkie panele dzielą jedno zaznaczenie. Klik w dowolny token w tekście przestawia jednocześnie heatmapę, attention, logit lens i Token Journey na tę samą pozycję, więc zawsze patrzy się na ten sam moment obliczeń z czterech różnych stron.
Heatmapa aktywacji neuronów
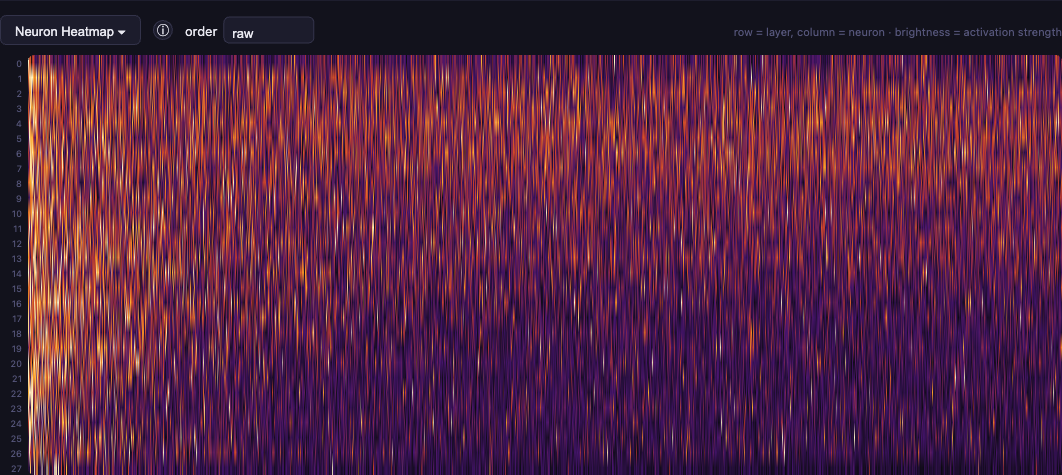
Model ma 28 warstw, a każda kończy swoje obliczenia szeroką siecią feedforward (SwiGLU MLP) z 3072 "neuronami". Heatmapa pokazuje, jak mocno każdy z nich zapalił się dla aktualnie wybranego tokenu — wiersz to warstwa, kolumna to neuron, jasność to |aktywacja|.
Dwa napotkane problemy:
- Skala. Kilka neuronów w każdej warstwie potrafi mieć wartości o rząd wielkości większe od reszty ("massive activations" — dobrze udokumentowane zjawisko w dużych modelach). Normalizacja po maksimum zgasiłaby wtedy wszystko poza tą garstką outlierów. Zamiast tego każda warstwa jest przycinana do swojego 99. percentyla i dodatkowo pierwiastkowana, co ściska dynamikę bez gubienia słabszych sygnałów.
- Kolejność neuronów. Ukryte jednostki MLP nie mają żadnego naturalnego porządku (permutation symmetry) — kolejność "z modelu" jest wizualnie czystym szumem.
compute_neuron_order.pyliczy raz, offline, stabilny porządek przez hierarchiczne klastrowanie korelacji aktywacji na zbiorze różnorodnych promptów, dzięki czemu skorelowane neurony lądują obok siebie. W interfejsie przełącza się to selektoremorder:raw,clusteredalboby mean.
Warto od razu powiedzieć, czego ta heatmapa nie robi: przy 3072 kolumnach ściśniętych do szerokości okna pojedynczy neuron zajmuje ułamek piksela, więc nie da się z niej niczego odczytać. To wyłącznie wizualizacja skali. Każdy z tych neuronów ma starannie dobraną wagę, którą wypracował kosztowny trening. Tym większe wrażenie robi fakt, że duże modele, z których korzystamy na co dzień, mają ich 100 razy więcej.
Attention
Kliknięcie dowolnego tokenu w tekście podświetla różowym kolorem wcześniejsze tokeny proporcjonalnie do tego, ile uwagi im poświęcił (uśrednione po 16 głowicach attention albo dla pojedynczej wybranej warstwy). Panel Attention Lens poniżej pokazuje ten sam wiersz w pełnej rozdzielczości: wiersz = wcześniejszy token, kolumna = warstwa (0–27), jasność = waga uwagi.
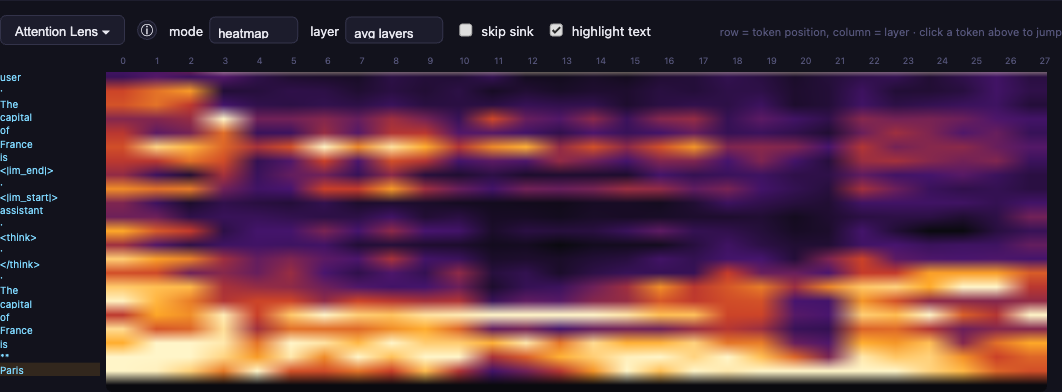
Ciekawostka implementacyjna: dlaczego dokładnie jeden kwadracik na warstwę, a nie jeden na głowicę? Bo 16 głowic jest uśrednianych już w momencie przechwytywania, po stronie Pythona, zanim cokolwiek trafi do danych wysyłanych do przeglądarki. Dla danej warstwy istnieje więc dokładnie jedna liczba na wcześniejszy token, a rozdzielczość per-głowica jest na tym etapie bezpowrotnie tracona — front-end nigdy jej nie widzi. Z tego samego powodu selektor warstwy nie wpływa na tryb heatmap, który zawsze pokazuje wszystkie 28 warstw naraz; działa tylko w trybie kolumnowym i na podświetleniu tekstu.
Druga rzecz warta uwagi: pierwszy token sekwencji regularnie zgarnia nieproporcjonalnie dużo uwagi na każdej warstwie — to znane zjawisko attention sink. Zostawiony jako punkt odniesienia zgasiłby resztę skali do czerni, więc jest wyłączony z normalizacji, choć nadal renderuje się z pełną intensywnością. Checkbox skip sink ukrywa go z panelu całkowicie i przelicza skalę względem reszty — różnica jest drastyczna. Przy generowaniu tokenu "Paris" bez tej opcji wszystko wygląda na równie ciemne; po jej włączeniu widać, że model patrzy przede wszystkim na "France" i "capital", czyli dokładnie tam, gdzie powinien.
Podgląd attention wymaga wag, których szybki domyślny kernel (sdpa) nigdy jawnie nie liczy — model trzeba załadować z attn_implementation="eager", co kosztuje około 8–9× więcej czasu na token.
Logit lens
Na każdej głębokości — wyjście embeddingu ("warstwa -1") i wyjście każdego z 28 bloków transformera — strumień rezydualny jest rzutowany przez finalną normalizację i lm_head modelu, tak jakby sieć skończyła liczyć właśnie tutaj. To pozwala podejrzeć, co model "sądzi" na długo przed faktycznym końcem obliczeń.
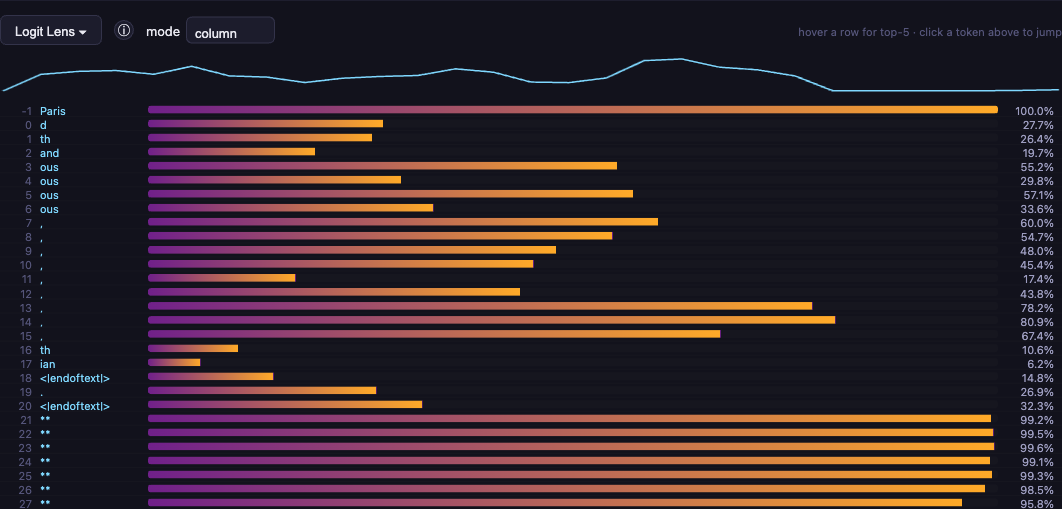
Dla warstw pośrednich to tylko przybliżenie: strumień rezydualny nie jest wyrażony w bazie, w której działa lm_head, aż do ostatniej warstwy, więc rzutowanie wcześniejszych głębokości przez tę samą macierz to heurystyka, a nie coś, do czego model był trenowany.
W praktyce widać dokładnie ten wzorzec. Dla promptu "The capital of France is" predykcja kolejnego tokenu po "Paris" jest przez pierwsze dwadzieścia warstw właściwie przypadkowa — pojawiają się tam urywki w rodzaju "ous" czy przecinek — a od warstwy 21 zatrzaskuje się na ** (zamknięcie pogrubienia) z pewnością 96–99% i już się nie zmienia. Obserwowanie, gdzie dokładnie następuje ten moment, jest samo w sobie interesujące.
Na samej górze listy widać jeszcze jeden artefakt: na głębokości -1, czyli tuż po embeddingu, model "przewiduje" po prostu ten sam token, który właśnie czyta. To nie błąd — Qwen3 ma związane wagi embeddingu i lm_head (lm_head.weight to dosłownie ten sam tensor co embed_tokens.weight), więc rzutowanie świeżego embeddingu z powrotem przez tę macierz najmocniej trafia w niego samego.
Generacja jest zachłanna — czysty argmax, bez samplingu. To celowe: dzięki temu najgłębszy wiersz logit lens wykonuje dokładnie to samo obliczenie, co sam model, i zgadza się z jego wyjściem co do bitu. Sampling wprowadziłby szum, który zaciemniłby to, co ten panel ma pokazywać.
Token Journey
Panel prowadzący pojedynczy, aktualnie wybrany token przez cały pipeline, od góry do dołu: tokenizacja (tekst → ID w słowniku) → wektor embeddingu → wnętrze jednego bloku transformera (z własnym stepperem warstw, niezależnym od reszty paneli) → wektor wyjściowy → predykcja → detokenizacja.
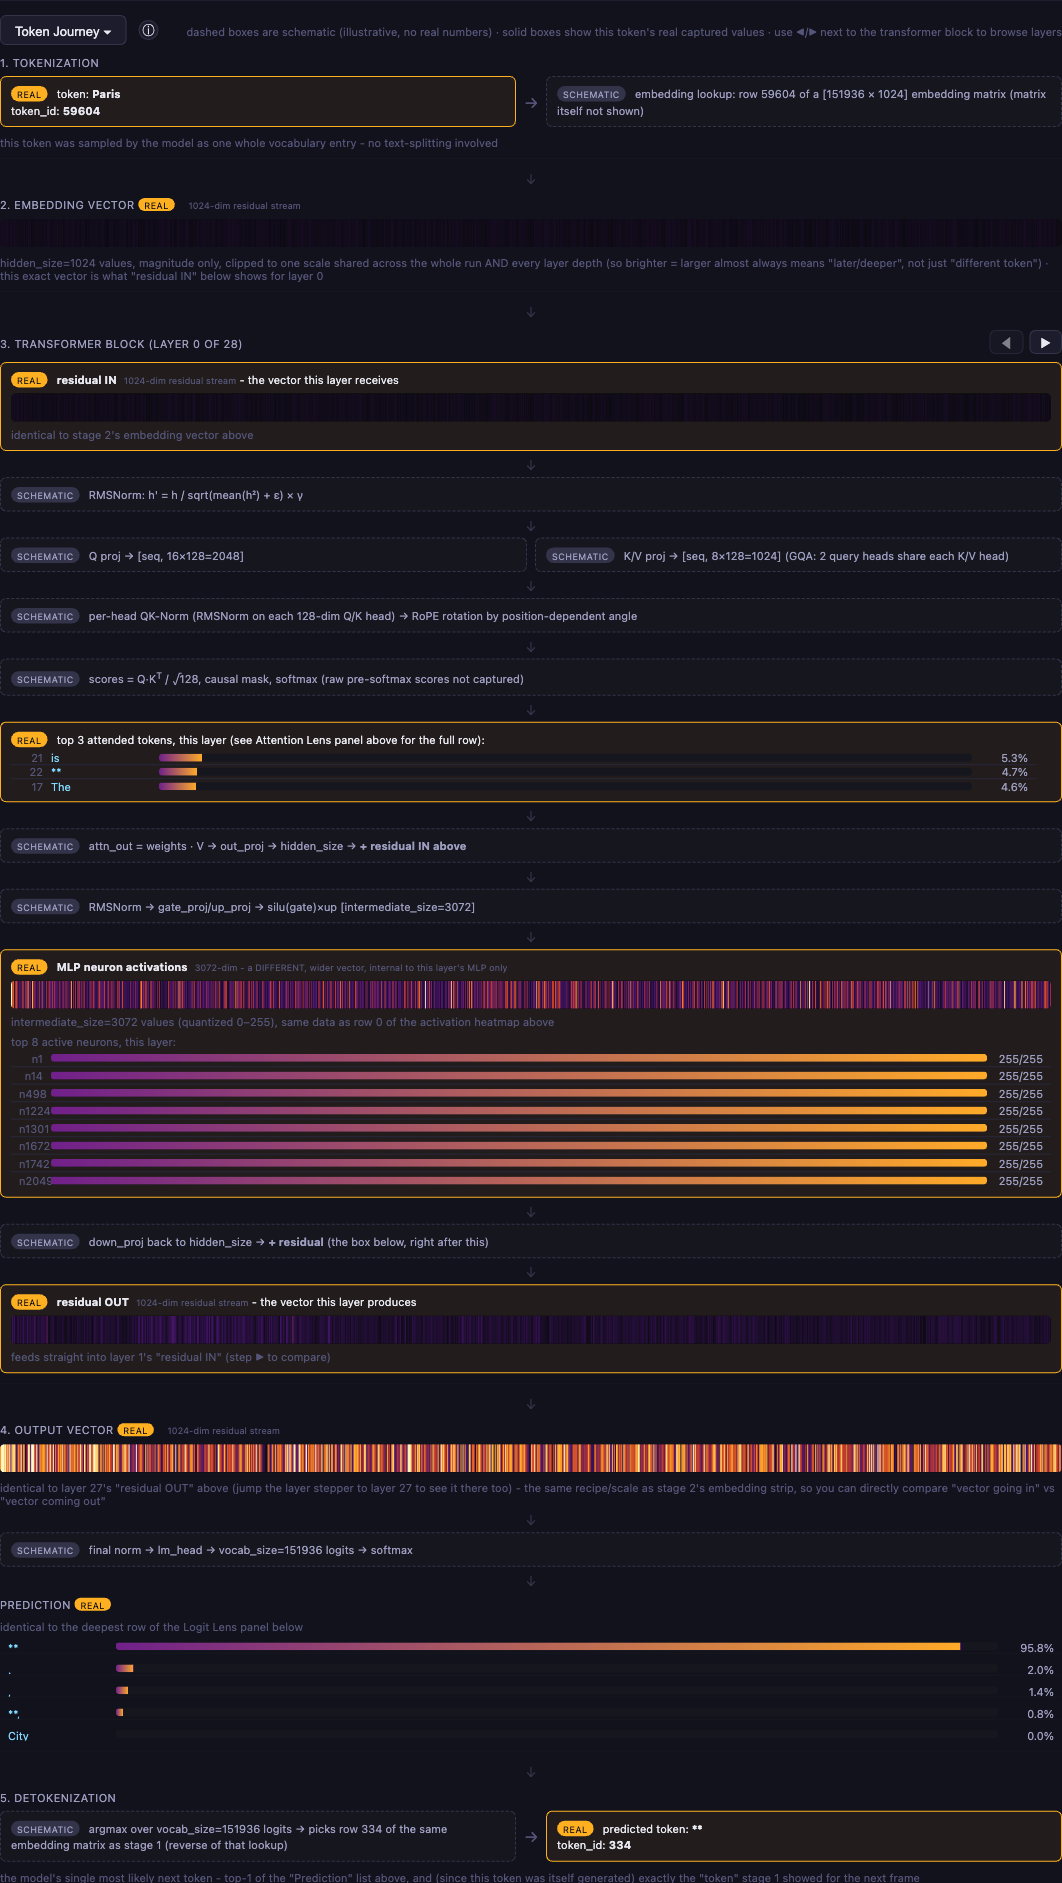
Cały panel trzyma się jednej zasady: nigdy nie pokazuje liczby, której nie przechwycił. Pomarańczowe, wypełnione ramki to realne wartości tego tokenu — te same liczby co w panelach powyżej, plus same wektory embeddingu, residual i wyjściowy jako małe paski-heatmapy. Ramki przerywane to schematy tego, czego aplikacja nie zapisuje ani nie przesyła: surowych wektorów Q/K/V, kątów RoPE, wyników przed softmaxem. Widać tam wzór i kształt tensora, ale nigdy zmyśloną liczbę.
Drobiazg, który łatwo przeoczyć, a który panel podaje poprawnie: w Qwen3 wymiar pojedynczej głowicy (128) nie wynika z podziału hidden_size przez liczbę głowic, bo to dałoby 1024/16 = 64. Projekcja Q wychodzi więc szersza niż sam strumień rezydualny — 16 × 128 = 2048 wobec 1024. Większość materiałów wyjaśniających transformery milcząco zakłada tu ten podział i podaje złe kształty.
1024-wymiarowy wektor pokazany jako "residual IN", "residual OUT", wektor embeddingu i wektor wyjściowy to na każdym etapie ta sama płynąca wielkość — OUT jednej warstwy jest identyczny z IN kolejnej, od embedding lookupu aż po finalny wektor wyjściowy. Przeskakując warstwy strzałkami bloku transformera, widać, jak ten jeden wektor stopniowo się odkształca, przechodząc przez wszystkie 28 warstw.
Dwa tryby: offline i live
Cała logika przechwytywania (ładowanie modelu, hooki, pętla generacji, logit lens) siedzi w jednym module i jest współdzielona przez dwa niezależne wejścia:
- Offline replay (
capture.py) — puszcza jeden prompt przez model i zapisuje cały przebieg jako samodzielny plik HTML, który można otworzyć offline i przewijać klatka po klatce. Współdzielony CSS/JS zestatic/jest wklejany bezpośrednio do pliku, więc wynik to jeden plik bez żadnych zewnętrznych zależności — to właśnie ten plik ląduje na GitHub Pages. - Live (
server.py) — trzyma model w pamięci i streamuje aktywność przez Server-Sent Events, w miarę jak wpisuje się kolejne prompty. Jedna instancja modelu obsługuje jedno żądanie naraz (prosty globalny lock) — wystarczające do użytku lokalnego, nie do wielu użytkowników naraz.
Wdrożenie i CI/CD
Statyczne demo aplikacji jest automatycznie budowane przez GitHub Action, a nie ręcznie odświeżanym zrzutem. Przy każdym pushu na main pipeline instaluje zależności, ściąga i cache'uje Qwen3-0.6B (~1,2 GB, tylko raz), odpala capture.py na CI-owym runnerze i publikuje wynikowy HTML na GitHub Pages przez oficjalną akcję actions/deploy-pages. Nic nie trafia z powrotem do commitów — wygenerowany plik żyje wyłącznie jako wdrożenie Pages, więc historia repozytorium nie puchnie o kolejną kopię tego samego, kilkumegabajtowego pliku przy każdym odświeżeniu.
Stack technologiczny
- PyTorch + Transformers (
AutoModelForCausalLM/AutoTokenizer) — ładowanie modelu, forward hooki nadown_projkażdej warstwy (przechwytują aktywacje MLP) i na wyjściu każdego bloku (przechwytują residual stream) - FastAPI + Server-Sent Events — tryb live
- Czysty JavaScript + Canvas, bez frameworka — świadomy wybór, żeby offline output mógł zostać jednym plikiem HTML bez etapu budowania
- NumPy / SciPy / Pillow — klastrowanie kolejności neuronów i skrypt weryfikacyjny
- pytest — testy, w tym golden test pilnujący, żeby pipeline liczbowy nie zaczął po cichu zwracać czegoś innego
- GitHub Actions — CI/CD do GitHub Pages
Ograniczenia
- Attention wymaga
attn_implementation="eager", ~8–9× wolniejszego niż domyślny szybki kernel — to cena za wyciągnięcie wag, których model normalnie nigdy jawnie nie materializuje. - Logit lens dla warstw pośrednich to heurystyka, nie ścisła interpretacja (patrz wyżej) — zgodność z faktyczną predykcją modelu jest gwarantowana tylko dla najgłębszej warstwy.
- Heatmapa upycha 3072 kolumny w szerokość okna, więc pojedynczego neuronu nie da się w niej odczytać — pokazuje wzór, nie konkret.
- Wagi attention są uśredniane po głowicach już przy przechwytywaniu, więc struktura pojedynczych głowic jest niedostępna.
- Twardy limit 300 nowych tokenów (model i tak zwykle trafia w EOS wcześniej) — każda klatka niesie ciężki payload (aktywacje + attention + logit lens), więc otwarty limit ryzykowałby wielogigabajtowy plik HTML albo bardzo długi stream.
server.pyobsługuje jedno żądanie generacji naraz — to nie jest hosting wieloużytkownikowy.- Kolejność neuronów w heatmapie jest arbitralna, dopóki nie uruchomi się raz
compute_neuron_order.py. - To narzędzie do obserwacji, nie do interwencji — nie da się w nim wyciszyć neuronu ani przyciąć attention i zobaczyć, jak zmieni się wyjście.